一、缘起:一节“说不清”的好课
2025年11月,江西师大附中历史教研组的一次常规听评课,让在场的人都沉默了片刻。
一位有着十余年教龄的历史教师刚讲完《冷战与国际格局的演变》。到了评课环节,教研组长杨老师抛出第一个问题:“这节课好在哪、还差在哪?”大家给出的答案高度一致——“讲得很完整”“互动还可以”“节奏稍微快了点”。可当组长追问“好在哪个环节”“互动够不够”“快了多少”时,没有人能给出具体答案。
这不是某一节课的偶然。在附中这样一所师资雄厚的学校,课堂教学质量评价长期依赖“推门听课、纸笔记录、公开课观摩”三板斧:听课覆盖率低,评价高度依赖听课者个人的经验与当下状态;课堂里真正发生的事——教师语速与情绪的起伏、学生专注度分钟级的波动、一个提问抛出后究竟候答了几秒、全班有多少人真正抬起了头——因为缺少采集手段而白白流失。等到教研反馈回到教师手中,往往已经过去一周,教学情境已经模糊,指导价值大打折扣。
更让管理者感到棘手的,是“名校经验”的传承难题。附中最宝贵的财富是那批名师:他们的课堂节奏感、提问设计、史料选取与情境创设,大多沉淀在“手感”和“直觉”里,属于典型的隐性知识。传统的师徒结对同样依赖“悟性”与“缘分”,一位青年教师的成长周期,常常要以五年、八年计。
“我们最缺的不是道理,是证据。”在学校教育评测中心汪主任的调研记录本上,这句话被反复写下。2026年4月,教育部等五部门印发《“人工智能+教育”行动计划》,明确提出利用智能技术分析课堂教学行为、开展人工智能循证教研。政策的方向与学校的痛点在同一个点上相遇——同月,学校组建专项组,“慧评优教”项目正式启动。
二、破题:把教研经验翻译成机器读得懂的量规
项目组很快意识到,这一类系统失败的原因往往不在算法,而在指标。
“如果直接把通用的课堂评价量表搬进来,评出来的一定是‘放之四海而皆准’的空话。”第一次研讨会上,科教处副主任张老师提出了最关键的约束:历史课必须用历史课的标准来评。史料怎么用、时空怎么立、结论从哪里来,这些是历史学科的教学逻辑,任何一份不分学科的通用量表都装不下。
于是,项目的第一个成果不是一行代码,而是一张表。
项目组以弗兰德斯互动分析系统(FIAS)及其高阶编码(HOALS)为基础框架,融合普通高中历史课程标准的核心素养要求,把历史课堂评价拆解为“教学目标、教学内容、教学过程、学生学习、核心素养培育”五个维度、共97个评分项:从“目标数量合理性”“目标可测性与显性化”,到“时间年代零错误”“论从史出原则”“史料可信度考证”“家国情怀熏陶”,每一个评分项都写清了三档行为描述和证据来源。
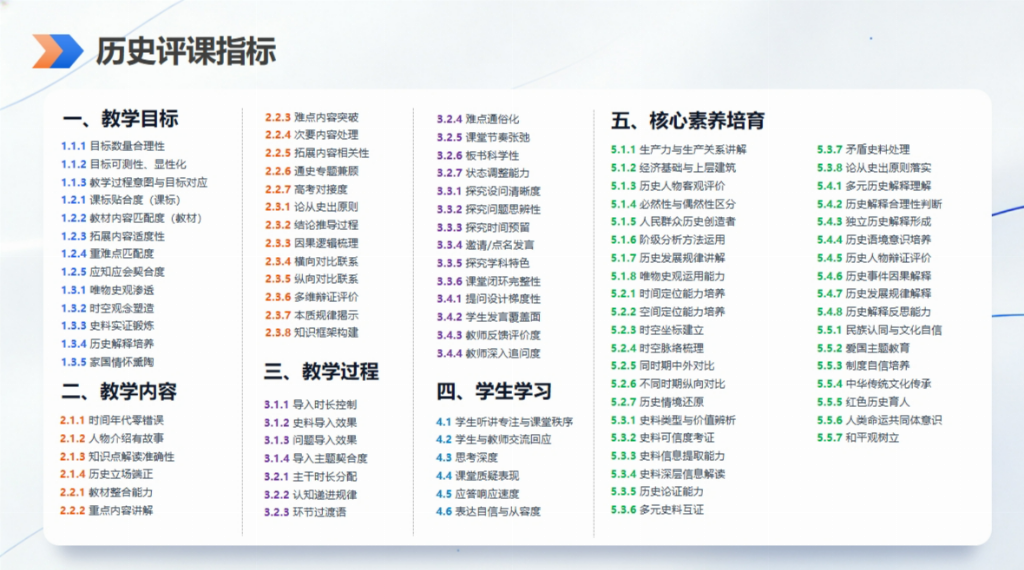
图 1 “慧评优教”历史常规课评价指标
这张表最特别的地方,是它给每一项指标都明确了一句“系统到哪里找证据、看什么”。比如“板书科学性”一栏,特别标注“只评价教学设计中的板书设计模块,不要求识别课堂板书动作”;“导入时长控制”一栏,直接给出“1—2分钟为优”的量化区间,让“节奏稍快”这样的模糊判断,变成了可以被核对的数字。权重也做了取舍:教学内容与教学过程各占30%,核心素养培育占20%,教学目标与学生学习各占10%——评的是课,不是热闹。
“以前评课是‘我觉得’,现在评课是‘我依据’。”参与指标研讨的一位骨干教师这样总结。
三、攻坚:让人工智能学会“讲证据”
指标是骨架,真正让它跑起来的是技术底座。而在技术路线上,项目组定下了一条近乎苛刻的原则:数据不出校,结论必须可追溯。
采集端是“无感”的。教室原有的常态化录播设备加装拾音模块,教师上课与往常一样,不需要佩戴任何设备,不需要点击任何按钮。后台由此获得完整的课堂音视频流:视觉算法识别师生行为与专注度分布,语音模型把整堂课转写成带时间戳的文本。
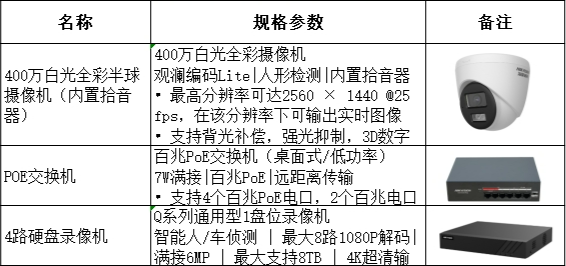
图 2 “慧评优教”录播硬件设备
真正的难点发生在“打分”环节。大模型最大的风险是“幻觉”——它可能编造出一段并不存在的课堂事实,甚至引用一段课堂里从未出现过的史料。项目组的解决办法,是把评价变成一道“填空题”而不是“问答题”。
一是量规先行。97项指标全部做成机器可读的结构化量规,评分档次预先写死,证据范围限定在白名单之内。人工智能拿到的是一道填空题,不是一道问答题。
二是证据检索。教材、课标、教案与课堂转写文本全部向量化入库,评分时先用语义与关键词双路检索,把最相关的原始片段自动送到每一条指标面前,每一次引用都留痕,可回溯到具体语句和具体时间点。
三是契约校验。系统对每一份输出做校验:引用不存在的证据、把别的指标的证据挪来使用,一律拒收重评。不是“相信人工智能”,而是“校验人工智能”——每一分都携带完整的证据链。
四是诚实标注。每一项指标都有“已评分、暂定、证据不足、不适用、失败”五种状态,证据不够就如实报告,宁可标注待核,也不返回一个“看起来很美”的分数。
2026年6月上旬,系统跑通了第一个完整链路。当教研专家在报告上看到“3.2.3环节过渡语,得分82,依据:第12分18秒‘下面我们换一个角度’”这样的表述时,有人说了句玩笑话:“这个人工智能,评课比我们还讲证据。”
四、生长:从一节课的复盘,到一群人的成长
2026年9月,系统进入真实课堂。首批选取2间常态化班级教室静默接入,不给授课教师增加任何额外任务。
青年教师王老师是第一批使用者。他工作第二年,课上得认真,却总觉得“差一口气”,又说不出差在哪里。第一次拿到自己的课堂报告时,他发现了一件意想不到的事:这节课她共提问23次,其中封闭性问题18个,“候答时间”平均只有2.1秒。
“2.1秒,意味着我抛出问题之后只等了两秒,就自己把答案说出来了。”他说,“学生根本没有思考的时间。这件事我上三年课,从来没有意识到。”
报告不止告诉他问题在哪里。同一天,他打开了系统里的“名师教学特征图谱”——那是从校内名师课堂数据中提取出的教学画像。他看到,同一位名师在讲同一课型时,候答时间在6秒以上,开放式问题占比接近一半。差距以数据的形式,清晰地摆在他面前。
在系统的另一端,名师的课堂报告则被另一位老师看到。教研组把优秀课例的“高光片段”提取出来,配上指标诊断,成为教研会上可以直接播放、逐项对照的样本。“以前说‘向名师学习’是一句口号,现在是一份可以对照的清单。”教研组长说。
试点阶段,项目组组织教研专家与系统报告开展“背靠背”双盲校验:同一节课,一边是专家的人工评课结论,一边是系统生成的报告,双方独立完成后比对;围绕一致性数据与每一条偏差点,反向微调评价权重与提示词,目标是把人工智能与人工评估的一致率提升到85%以上。指标也从V1.0滚动到V2.0,并沉淀为2026年9月定版的《慧评课堂·智能评课标准(历史学科常规课)》——97个评分项,版本号2026.09.01.1。
变化不止在历史一科。2026年10月初,基于同一套底层架构的数学学科评课指标同步完成——数学抽象、逻辑推理、数学建模、直观想象、数学运算、数据分析六大素养被拆解为五十余个评分项。“评历史课,就用历史课的标准;评数学课,就用数学课的标准。”同一套基础设施支撑起不同学科的评价需求,让学校的信息化投入获得了更高的复用率。
五、辐射:从一间教室,到一片区域
到2026年10月,项目已经走完“基建与调研—算法联调与底座开发—单点试点与校准”三个阶段。按照推进表,2026年11月至12月将完成模型校准与系统优化版V2.0,同期申请软件著作权;2027年起分批接入全校教室,完成并发压测,面向全体教师开展人工智能循证教研工作坊,并为教务处提供全域教学质量看板。
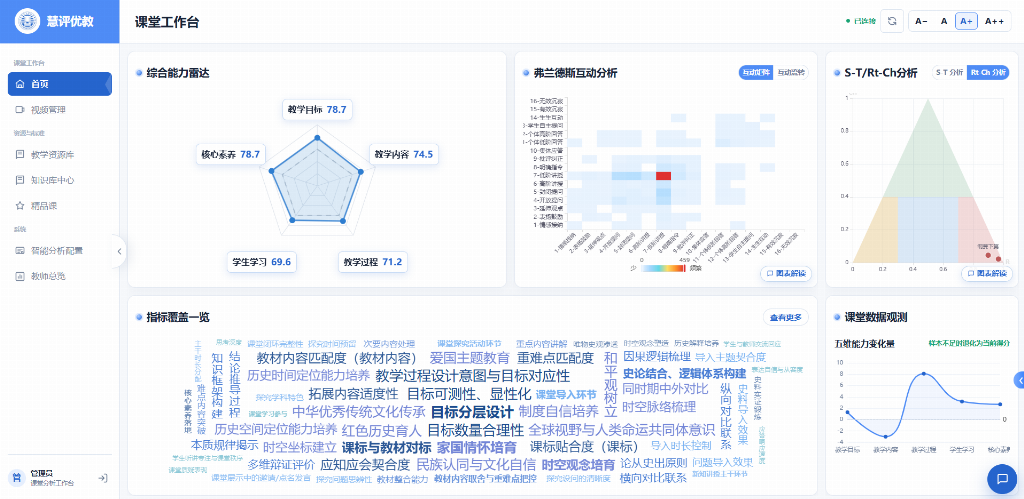
图 3 “慧评优教”系统看板首页
比时间表更值得期待的,是这件事本身的意义。一所学校真正的教学质量,藏在每一间教室的每一分钟里。过去,这些分钟随下课铃声落定即散;现在,它们以数据的形式被保存、被分析、被回看,并且能够回答一位教师职业生涯中最重要的问题——“我还可以怎么做得更好?”
“技术的精度,是为了传递教育的温度。”项目组把这句话写进了系统首页。当人工智能不再只是一个“打分器”,而是一位随时可以请教的教研伙伴,教育数字化转型才真正走到了教师身边。下一步,学校希望把这套已经跑通的范式输出为可复制、可推广的“附中标准”,为全省基础教育的人工智能应用提供一间可以照搬的“样板间”。