当前,AI大模型正从参数规模竞赛加速向产业场景落地,数据中心、云计算与大模型推理场景对算力效率、能耗水平与部署成本的要求持续提升。而传统冯·诺依曼架构下的“存储墙”问题日益凸显,数据传输与计算的耗时呈现约100:1的不平衡状态,大量算力消耗在数据搬运环节,成为制约AI算力释放的核心瓶颈。在行业对下一代算力架构的探索中,通用存算一体被视为重要的破局方向。作为国内首家基于通用存算一体架构的AI大算力芯片企业,亿铸科技凭借全链条的技术创新与产业实践,构建了差异化的竞争力。亿铸科技核心优势,集中体现在架构设计、介质突破、技术路线与落地价值等多个维度,为后摩尔时代的AI算力演进提供了可参考的底层框架与落地方案。
一、通用存算一体架构创新,重构算力底层逻辑
传统存算分离的架构下,数据需要在存储单元与计算单元之间反复搬运,既带来了极高的功耗损耗,也导致计算单元的有效利用率偏低。亿铸科技提出的通用存算一体架构,从计算底层减少数据搬运损耗,同时突破了传统存算方案的专用性局限,同时满足架构通用、生态通用与计算通用三重属性。
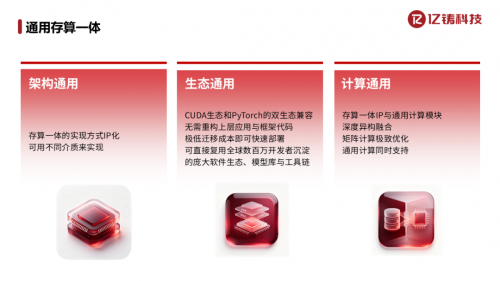
架构通用层面,存算一体的实现方式采用IP化设计,可基于不同介质实现,不绑定单一存储材料,为后续技术迭代预留了充足空间;生态通用层面,方案实现CUDA生态与PyTorch双生态兼容,无需重构上层应用与框架代码,能够以较低迁移成本快速部署,复用现有开发者生态、模型库与工具链;计算通用层面,存算一体IP与通用计算模块深度异构融合,既可以优化加速矩阵计算,也同时支持通用计算,能够独立承担完整的AI计算任务,而非仅作为协处理器存在。
这一架构设计也契合产业演进的底层规律:仅能解决单一计算问题的专用方案,最终往往会成为通用平台的补充;而兼具效率与通用性的架构,才能成为支撑下一代算力基础设施的核心力量。
二、3D DRAM技术突破,筑牢容量与带宽双底座
存储容量与数据带宽,是决定存算一体方案能否支撑云端大算力场景的关键基础。行业内早期的存算一体方案普遍受限于存储容量,难以承载百亿、千亿参数级别的大模型,也无法适配长上下文推理等新兴需求。
亿铸科技选择3D DRAM作为核心存储介质,从物理层面突破了容量瓶颈,为存算一体芯片从MB级容量迈向GB级甚至更高容量提供了支撑,能够承载更大规模的模型参数,适配云端大模型推理的算力需求。同时,3D堆叠技术不仅提升了存储密度,还能够显著拉高存储带宽与数据吞吐能力,而大模型Token持续生成的过程高度依赖高速数据传输,大容量叠加高带宽的组合,直接决定了最终的推理输出效率。
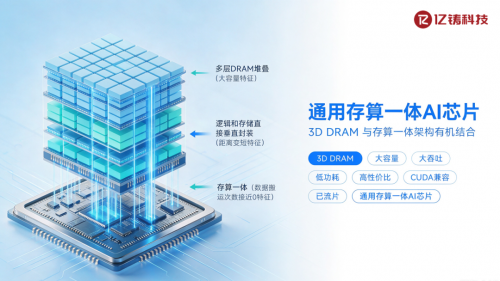
基于3D DRAM的技术底座,方案还能够支持1M超长上下文窗口、混合精度与MoE稀疏计算、集群级KV Cache池化等特性,有效降低KV Cache检索延迟,提升长程任务处理能力与有效算力吞吐,适配Agentic AI时代的新算力需求。
三、全数字存算一体方案,保障高精度与高可靠性
在存算一体的技术路线中,计算精度是决定方案能否落地商用的核心指标之一。模拟计算路线受器件特性、环境变化等因素影响,容易出现误差逐层叠加,难以满足大模型推理的高精度要求。
亿铸科技采用全数字存算一体的技术路线,回归数字电路的确定性逻辑,从根本上消除了器件非理想性带来的精度损失,为大模型推理所需的高精度计算提供了稳定保障。同时,数字存算架构具备更强的容错能力与架构集成性,在数据存储可靠性与量产成本控制上也更具优势,能够适配数据中心、云端服务器等场景下的长期稳定运行需求。
四、能效与成本双优,支撑产业规模化落地
架构、介质与路线的创新,最终落地为产品端的性能与成本优势。经测试验证,对比主流云端GPU,亿铸通用存算方案可实现约2倍性能提升、约1/5功耗、约1/6成本的综合表现;经第三方机构验证,其能效比超出传统架构AI芯片平均性能的10倍以上。
在大模型推理场景下,同等业务规模的推理算力总拥有成本最高可下降约88%,能够有效降低数据中心的运营成本,为AI规模化商业化落地提供高性价比的算力底座。依托全栈自研的技术栈,亿铸科技已形成覆盖云边端多场景的产品矩阵,能够满足不同规模、不同应用场景的算力需求,同时通过兼容主流开发生态的软件平台,大幅降低了客户的开发适配门槛。
从底层架构创新到介质技术突破,从全数字路线选择到落地场景的价值验证,亿铸科技核心优势始终围绕“破解存储墙瓶颈、释放算力效能”的核心目标展开。作为通用存算一体赛道的先行者,亿铸科技持续深耕全数字3D DRAM通用存算一体技术路线,以架构创新驱动算力效率提升,不仅为AI算力产业提供了新的演进路径,也将为中国AI大算力产业的自主可控发展,以及千行百业的智能化升级提供坚实的算力支撑。